Introducing Gemma 4 12B: A Unified, Encoder-Free Multimodal Model
发表时间: 2026-06 · Blog post by Google (blog.google)
文章作者/机构: Olivier Lacombe (Google Deepmind 产品管理总监), Gus Martins (Google DeepMind 产品经理)
速读
一句话结论 Google DeepMind 团队于 2026 年 6 月推出了 Gemma 4 12B,这是一款采用无编码器统一架构的 12B 参数多模态模型,它在将显存占用减半、支持在 16GB 内存笔记本上本地运行的同时,实现了接近 26B 混合专家模型的先进推理与智能体能力。
要解决什么问题 原有的大型多模态模型通常依赖分离式的架构设计,即使用独立的视觉编码器和音频编码器来转换图像与音频信号,随后再将这些中间表示传递给语言模型处理。这种分离式编码器机制存在明显的卡点:它不仅会显著增加系统的端到端延迟,还会大幅推高整体的内存与显存使用量。这一显存与计算开销的瓶颈,导致具备高级多步推理和智能体(agentic)能力的先进多模态模型难以在消费级硬件(如普通笔记本电脑)上本地部署。如果强行缩小模型规模以适应边缘设备,又往往会牺牲模型的多模态理解与复杂推理性能,难以在效率与先进能力之间找到平衡。核心目标就是开发一款中等规模的模型,既能保持接近大型模型的先进推理能力,又能足够高效以便在消费级硬件上本地运行,从而在不牺牲性能的前提下让高级多模态和智能体体验普及化。
怎么做的 核心思路是彻底抛弃传统的多模态独立编码器,采用一种新颖的无编码器(encoder-free)统一架构,让视觉和音频输入直接流入大型语言模型(LLM)的骨干网络中。这种设计通过消除额外的编码器网络,直接绕开了前述的延迟与显存卡点,简化了结构。关键设计由三个主要部件构成:首先是视觉处理模块,作者用一个极轻量级的嵌入模块替换了原有的视觉编码器,该模块仅包含一次矩阵乘法、位置嵌入(positional embedding)和归一化(normalization)操作,从而让 LLM 骨干网络直接接管深层的视觉处理任务;其次是音频处理模块,该设计完全移除了音频编码器,将原始的音频信号直接投影到与文本词元(text tokens)完全相同的维度空间中,实现了原生处理多模态输入的方式,这也是谷歌首款具备原生音频输入功能的中等规模模型;最后是推理加速部件,模型配备了多词元预测(Multi-Token Prediction, MTP)drafter,专门用于进一步减少推理阶段的延迟。
效果如何 实验基于 12B 参数量的密集型(dense)多模态模型展开,目标运行硬件设定为配备 16GB VRAM 或统一内存的消费级笔记本电脑。对比的基线方法主要是更大规模的 Gemma 4 26B 模型,它代表了采用混合专家(MoE)架构的先进大模型路线;同时在性能定位上也对比了 E4B 模型,它代表了边缘友好型路线。在多个标准基准测试下,Gemma 4 12B 展现出了接近参数量两倍多的 26B MoE 模型的性能表现,能够支撑强大的多步推理和智能体工作流,而其总内存占用不到 26B MoE 模型的一半。该模型在 Apache 2.0 许可下发布,权重可通过 Hugging Face 和 Kaggle 获取。在生态支持上,它不仅支持通过 LM Studio、Ollama、Google AI Edge Gallery App、Google AI Edge Eloquent app 和 LiteRT-LM CLI 进行本地推理,还兼容 llama.cpp、MLX、SGLang、vLLM 等开发框架以及 Unsloth 微调工具。为了支持智能体开发,官方专门发布了 Gemma Skills 库,并支持通过 Google Cloud 平台的 Gemini Enterprise Agent Platform Model Garden、Cloud Run 和 Google Kubernetes Engine 进行云端部署。
A1 主要贡献
本文介绍了 Gemma 4 12B,这是一款旨在将具备智能体(agentic)能力的高性能多模态智能直接引入笔记本电脑的最新模型。该模型旨在弥合边缘友好型模型E4B与更先进的26B混合专家(MoE)模型之间的差距,通过减小的内存占用封装了强大的功能。
研究目标与核心问题:
核心目标是开发一款中等规模的模型,它既能保持接近大型模型的先进推理能力,又能足够高效以便在消费级硬件(如笔记本电脑)上本地运行。这解决了在不牺牲性能的前提下,让高级多模态和智能体体验普及化的挑战。
主要创新点:
Gemma 4 12B 的独特性体现在以下几个方面:
- 新颖的统一架构:模型不使用传统的多模态编码器。视觉和音频输入直接流入大型语言模型(LLM)的骨干网络,简化了结构并降低了延迟。
- 先进的推理能力:在基准测试中,其性能接近于更大的26B模型,从而能够支持强大的多步推理和智能体工作流。
- 为笔记本电脑优化:模型足够小,仅需16GB的VRAM或统一内存即可在本地运行。
- 开放与可及性:模型在 Apache 2.0 许可下发布,并获得了整个开发者生态系统的支持。
- 支持Drafter:Gemma 4 12B配备了多词元预测(Multi-Token Prediction, MTP)drafter,以减少推理延迟。
- 原生音频输入:这是谷歌首款具备原生音频输入功能的中等规模模型。
这些特性共同作用,使得先进的多模态能力能够在日常硬件上实现,而无需在速度或推理能力上做出妥协。
A3 关键观察与设计原则
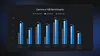
在本地运行最先进的智能体。Gemma 4 12B 在标准基准测试中的性能接近于我们更大的26B混合专家(MoE)模型,但其总内存占用不到后者的一半。该模型足够小,可以在配备16GB RAM的消费级笔记本电脑上本地运行,从而直接在用户的设备上解锁强大的多模态和智能体体验。
A2 方法细节
体验独特高效的统一架构。Gemma 4 12B 的突出之处在于其处理视觉和音频输入的流线型方法。传统的多模态模型通常依赖独立的编码器来转换图像和音频,然后才将这些表示传递给语言模型。由于这种分离式编码器会增加延迟并提高内存使用量,我们训练 Gemma 4 12B 时采用了一种无编码器(encoder-free)的架构,以直接集成音频和视觉输入。
原生处理多模态输入的方式。Gemma 4 12B 通过以下方式原生处理多模态输入:
- 视觉处理:我们用一个轻量级的嵌入模块取代了Gemma 4的视觉编码器,该模块仅由一次矩阵乘法、位置嵌入和归一化组成。这种设计使得大型语言模型(LLM)的骨干网络能够直接接管视觉处理任务。
- 音频处理:我们进一步简化了音频处理。我们完全移除了音频编码器,并将原始音频信号直接投影到与文本词元(text tokens)相同的维度空间中。
对于希望了解技术分解的开发者,可以参阅我们配套的《Gemma 4 12B 开发者指南》【一篇详细介绍该模型技术细节的博客文章,URL: https://developers.googleblog.com/gemma-4-12b-the-developer-guide/】 。
A4 实验环境
- 模型架构:Gemma 4 12B,一个拥有120亿参数的密集型(dense)多模态模型。其关键特性是采用统一的、无编码器的架构,能原生处理视觉和音频输入。该模型定位介于边缘友好的E4B模型和更大型的26B混合专家(MoE)模型之间。
- 硬件配置:模型设计用于在消费级硬件上运行,特别是配备16GB VRAM或统一内存的笔记本电脑。
- 软件配置:
- 模型获取:权重检查点可通过 Hugging Face 和 Kaggle 下载。
- 本地推理工具:支持在 LM Studio、Ollama、Google AI Edge Gallery App、Google AI Edge Eloquent app 和 LiteRT-LM CLI 中运行。
- 开发框架:支持通过 Hugging Face Transformers、llama.cpp、MLX、SGLang 和 vLLM 实现本地推理。
- 微调工具:支持使用 Unsloth 进行高效微调。
- 智能体开发:提供了官方的 Gemma Skills GitHub 仓库。
- 云部署:支持通过 Google Cloud 平台进行部署,具体包括 Gemini Enterprise Agent Platform Model Garden、Cloud Run 和 Google Kubernetes Engine (GKE)。
A4 实验结果
本文的主要实验结果通过性能对比图表和文字描述呈现,旨在说明 Gemma 4 12B 相对于更大模型的效率和性能。
- 实验内容:将 Gemma 4 12B 模型与更大规模的 Gemma 4 26B (MoE) 模型在多个标准基准测试上进行性能比较。
- 实验结果:如文中的基准测试图所示(详见图
- 分析结论:Gemma 4 12B 在性能上接近于参数量两倍多的 26B MoE 模型,但其总内存占用不到后者的一半。这一结果证明,该模型成功地在保持强大推理能力的同时,实现了在消费级硬件上高效运行的设计目标,为在本地设备上部署高级多模态应用和智能体提供了可能。
A7 补充细节
立即开始。开发者可以通过以下多种方式开始使用 Gemma 4 12B:
- 亲身体验:通过几次点击即可在 https://lmstudio.ai/models/gemma-4、https://ollama.com/library/gemma4、https://developers.google.com/edge/gallery、https://ai.google.dev/edge/eloquent 应用以及 https://ai.google.dev/edge/litert-lm/cli 中进行实验。
- 下载权重:直接从 https://huggingface.co/collections/google/gemma-4 和 https://www.kaggle.com/models/google/gemma-4 下载预训练和指令微调的检查点。
- 集成与学习:查阅https://ai.google.dev/gemma/docs/core和https://ai.google.dev/gemma/docs/capabilities/text/basic。
- 使用您喜欢的开发工具:使用 https://huggingface.co/google/gemma-4-12B-it、https://huggingface.co/collections/ggml-org/gemma-4、https://huggingface.co/collections/mlx-community/gemma-4、https://docs.sglang.io/cookbook/autoregressive/Google/Gemma4 和 https://docs.vllm.ai/projects/recipes/en/latest/Google/Gemma4.html 实现本地推理管道,或使用 https://unsloth.ai/docs/models/gemma-4 进行高效微调。
- 通过 Gemma Skills 解锁智能体开发:为了支持使用最新的 Gemma 进展构建智能体,我们发布了官方的 https://github.com/google-gemma/gemma-skills。这是一个专为使用 Gemma 模型构建智能体而设计的技能库。
- 按您的方式部署:使用 Google Cloud 启动生产环境中的端点。通过 https://console.cloud.google.com/agent-platform/publishers/google/model-garden/gemma4;publisherModelVersion=gemma-4-12b-it、https://codelabs.developers.google.com/codelabs/cloud-run/cloud-run-gpu-rtx-pro-6000-gemma4-vllm 和 https://docs.cloud.google.com/kubernetes-engine/docs/tutorials/serve-gemma-gpu-vllm 进行部署。
A5 结论
Gemma 4 12B 是一款创新的中等规模多模态模型,其核心优势在于其统一的、无编码器的架构,能够高效地在消费级笔记本电脑上运行。该模型通过直接将视觉和音频输入整合到LLM骨干网络中,显著降低了内存占用和延迟,同时保持了接近于大型模型的先进推理能力。
Gemma 4 12B 的发布,特别是其对原生音频输入的支持和在 Apache 2.0 许可下的开放获取,旨在推动开发者社区在本地设备上构建新一代的智能体和多模态应用。我们对开发者社区将利用这一新模型创造出的成果充满期待。